
Hi! I am Hairong Shi (史海容). I am a first-year Master’s student in Computer Science at Keio University, where I am fortunate to be supervised by Professor Komei Sugiura. My research interests lie in Vision-Language Model and Computer Vision.

I am a member of SMILAB@Keio University since September 2025. I received my Bachelor’s degree in Biomedical Engineering from the School of Biological Science and Medical Engineering at Beihang University. During my undergraduate studies, I had the privilege of working as a Research Assistant for two years at Colab@Beihang with Professor Si Liu. I have also gained industry experience as an AIGC Research Intern at RightBrain.AI.
こんにちは。史海容(Hairong Shi)です。現在、慶應義塾大学で杉浦孔明教授のご指導のもと、情報理工学専攻の修士1年です。研究分野は Vision-Language Model と Computer Vision です。
2025年9月より SMILAB@Keio University に所属しています。北京航空航天大学 生物医学工程学院 で生体医工学の学士号を取得しました。学部在学中は、Si Liu 教授のもと Colab@Beihang で2年間リサーチアシスタントとして研究に従事しました。また、RightBrain.AI で AIGC リサーチインターンとしての産業経験もあります。
🔥 Newsニュース
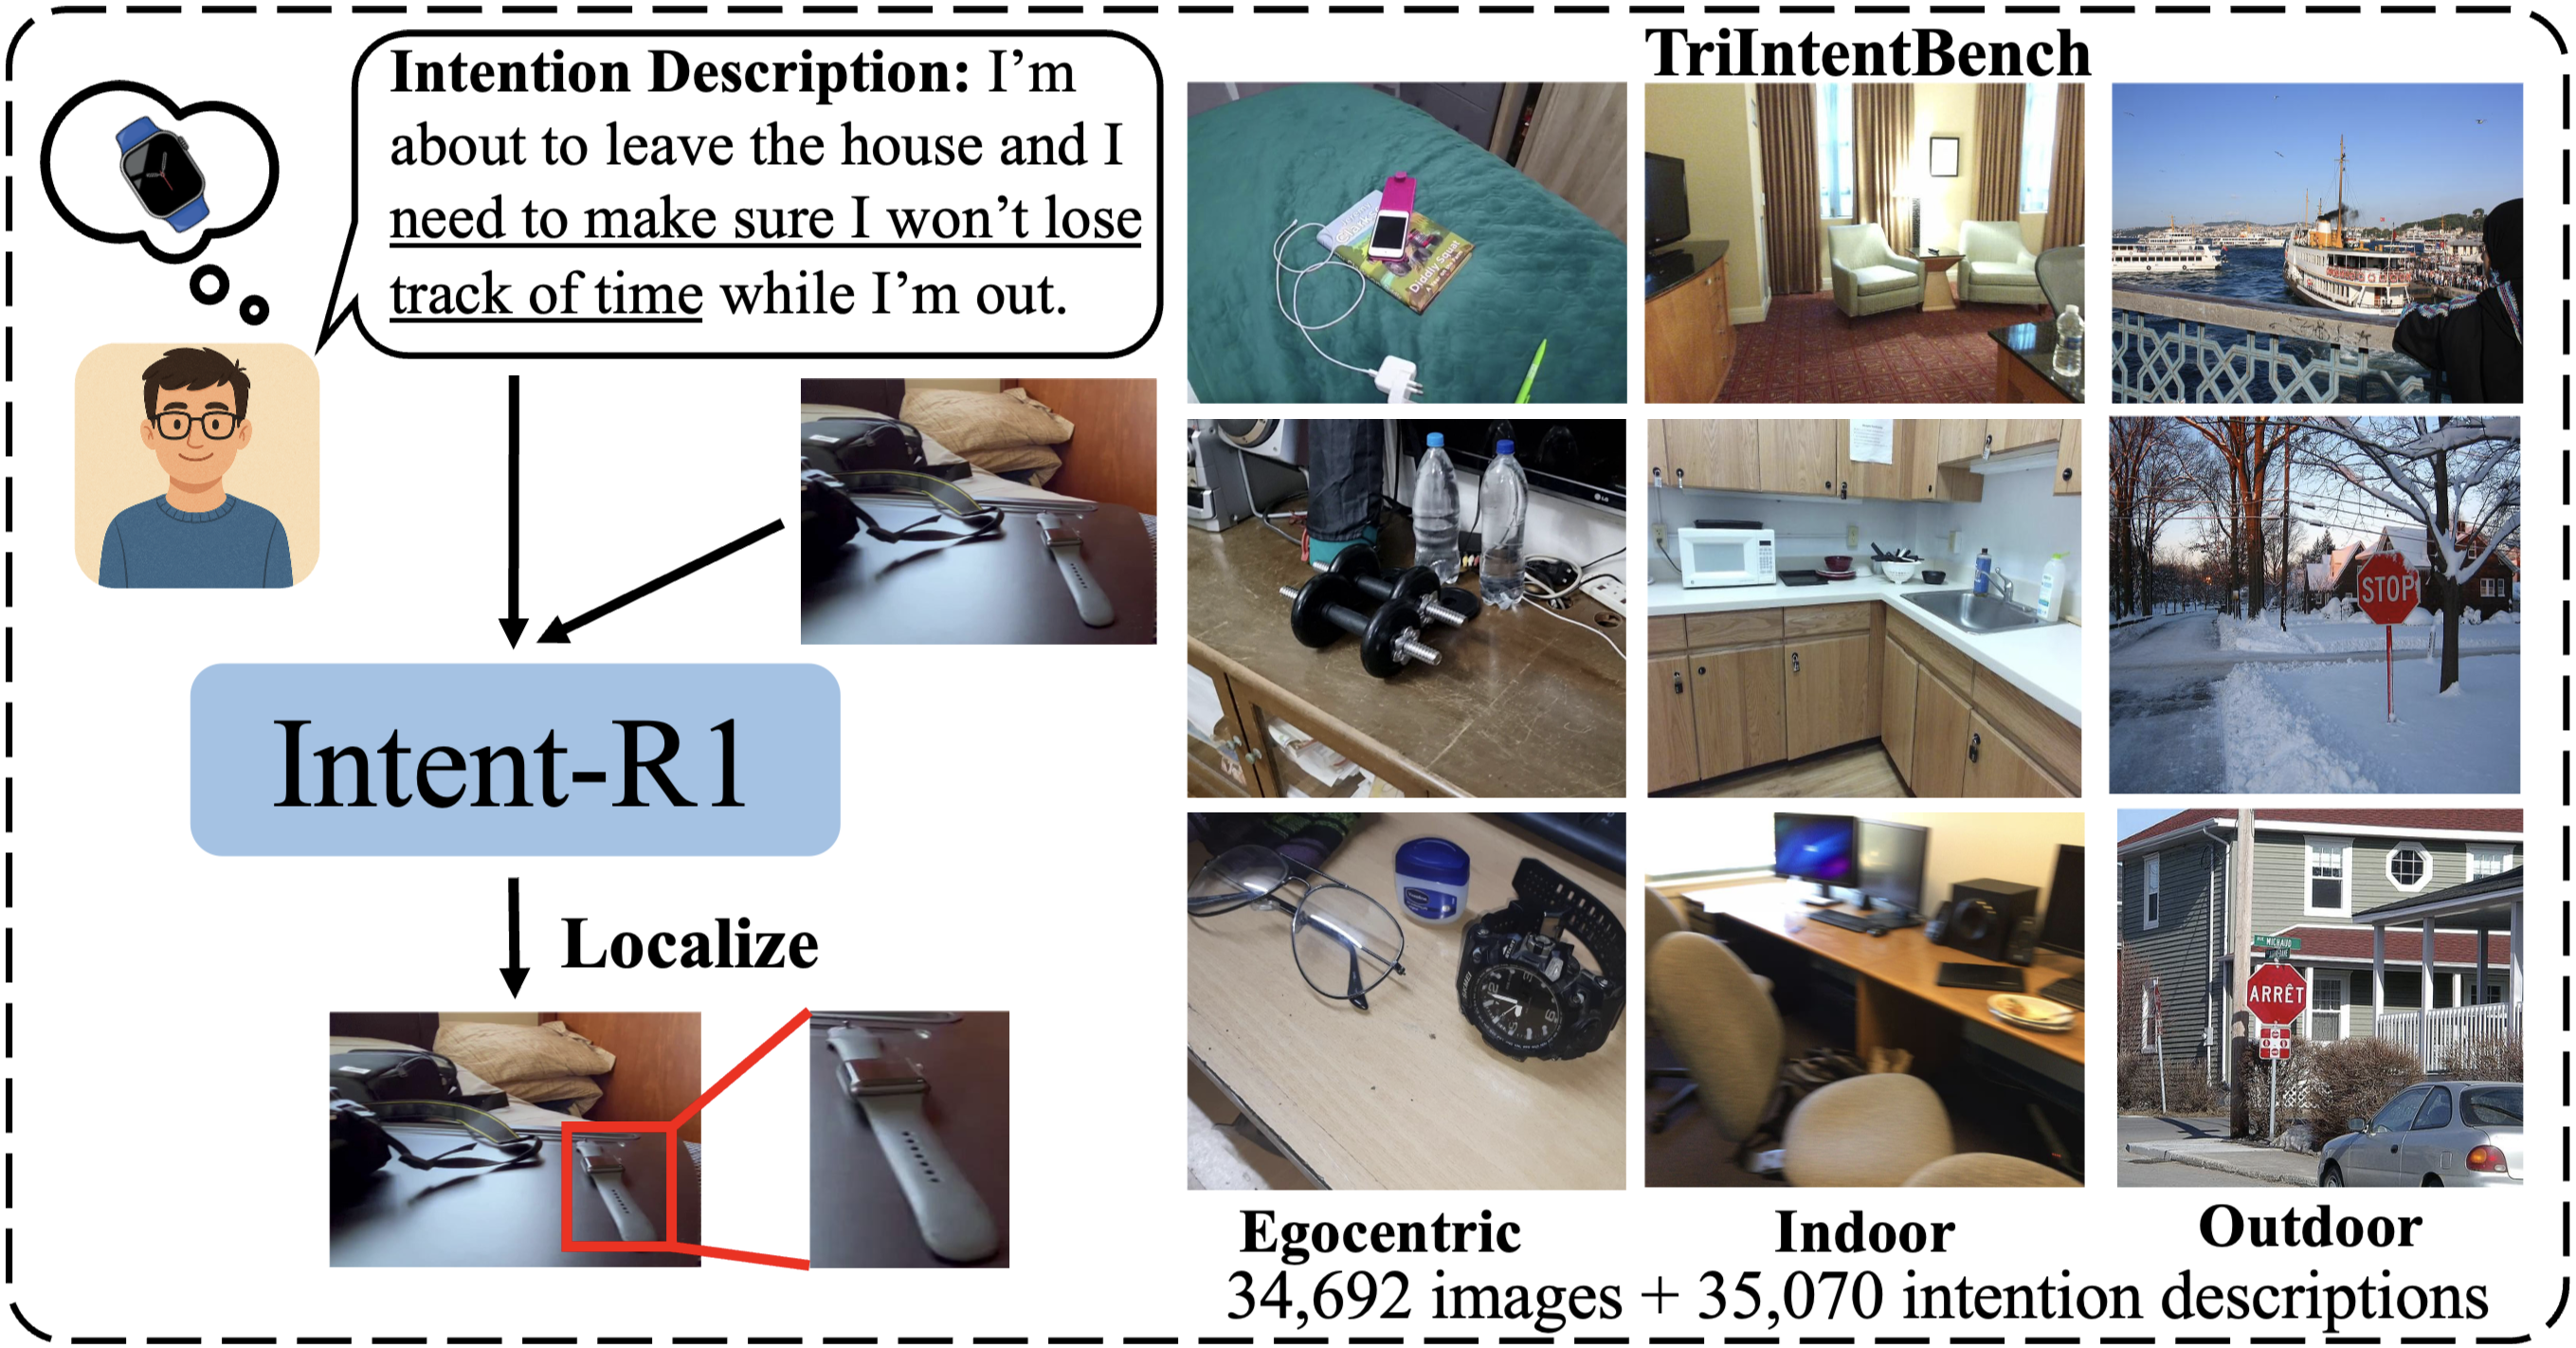
- 2026.06: 🎉🎉 Our paper “Dual-Reward Reinforcement Learning for Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes” was accepted to MIRU 2026 (第29回 画像の認識・理解シンポジウム) as an Oral Presentation (Acceptance Rate: 33.5%)!
- 2026.05: 🎉🎉 One paper was Early Accepted to MICCAI 2026 (Top 9%)!
- 2025.03: 🎉🎉 Started my AIGC Research Internship at RightBrain.AI.
- 2024.12: 🎉🎉 Our paper “VideoEspresso” was accepted to CVPR 2025 as an Oral presentation (Top 0.7%)!
- 2024.06: 🎉🎉 Our paper “Mask-Enhanced Segment Anything Model” was accepted to MICCAI 2024!
- 2026.06: 🎉🎉 論文 “多様なシーンにおける Open-Vocabulary Intention-Guided Object Detection” が MIRU 2026 (第29回 画像の認識・理解シンポジウム) に 口頭発表 として採択されました(採択率: 33.5%)!
- 2026.05: 🎉🎉 論文1編が MICCAI 2026 に Early Accept として採択されました(Top 9%)!
- 2025.03: 🎉🎉 RightBrain.AI で AIGC リサーチインターンを開始しました。
- 2024.12: 🎉🎉 論文 “VideoEspresso” が CVPR 2025 に 口頭発表 として採択されました(Top 0.7%)!
- 2024.06: 🎉🎉 論文 “Mask-Enhanced Segment Anything Model” が MICCAI 2024 に採択されました!
📝 Publications研究実績


Songhao Han, Wei Huang, Hairong Shi, Le Zhuo, Xiu Su, Shifeng Zhang, Xu Zhou, Xiaojuan Qi, Yue Liao, Si Liu
| Project | Paper | CVPR 2025 Oral Presentation (Top 0.7%) |

Mask-Enhanced Segment Anything Model for Tumor Lesion Semantic Segmentation
Hairong Shi, Songhao Han, Shaofei Huang, Yue Liao, Guanbin Li, Xiangxing Kong, Hua Zhu, Xiaomu Wang, Si Liu
| Project | Paper | MICCAI 2024 Poster (Acceptance Rate: 31%) |
Mask-Enhanced Segment Anything Model for Tumor Lesion Semantic Segmentation
Hairong Shi, Songhao Han, Shaofei Huang, Yue Liao, Guanbin Li, Xiangxing Kong, Hua Zhu, Xiaomu Wang, Si Liu
| Project | Paper | MICCAI 2024 ポスター(採択率: 31%) |
🎤 Talks講演
🎖 Honors and Awards受賞・奨学金
- 2025.11 2025 Academic Year Monbukagakusho Honors Scholarship, JASSO for Privately Financed International Students
- 2025.06 Outstanding Graduate Prize, Beihang University
- 2024.06 Academic Excellence Scholarship (Second Prize), Beihang University
- 2023.10 Voyage Program Scholarship, Beihang University
- 2023.06 Academic Excellence Scholarship (Second Prize), Beihang University
- 2022.06 Academic Excellence Scholarship (First Prize), Beihang University
- 2025.11 2025年度 文部科学省外国人留学生学習奨励費, JASSO
- 2025.06 優秀卒業生賞, 北京航空航天大学
- 2024.06 学業優秀奨学金(二等), 北京航空航天大学
- 2023.10 Voyage Program Scholarship, 北京航空航天大学
- 2023.06 学業優秀奨学金(二等), 北京航空航天大学
- 2022.06 学業優秀奨学金(一等), 北京航空航天大学
📖 Education学歴
- 2025.09 - 2027.09, Master of Computer Science, Keio University, Japan
- 2021.09 - 2025.06, Bachelor of Biomedical Engineering (Medical Artificial Intelligence), Beihang University, China
- GPA: 3.78/4.0 (Top 5%), Rank: 4/72
- 2025.09 - 2027.09, 修士(情報理工学専攻), 慶應義塾大学, 日本
- 2021.09 - 2025.06, 学士(生体医工学・医療人工知能), 北京航空航天大学, 中国
- GPA: 3.78/4.0(上位5%), 順位: 4/72
🔬 Research Experience研究経験
- 2023.09 - 2025.03, Research Assistant, Colab@Beihang, supervised by Prof. Si Liu
- Focused on video understanding and medical image segmentation. Contributed to the “VideoEspresso” and “M-SAM” projects, leading to publications at CVPR and MICCAI.
- 2023.04 - 2023.07, Research Assistant, Beihang University, supervised by A.P. Guanglei Zhang
- Conducted research on Medical Computer Vision
- 2023.09 - 2025.03, リサーチアシスタント, Colab@Beihang, 指導教員: Si Liu 教授
- 動画理解と医用画像セグメンテーションに関する研究に従事しました。”VideoEspresso” と “M-SAM” プロジェクトに貢献し、CVPR および MICCAI での発表につながりました。
- 2023.04 - 2023.07, リサーチアシスタント, 北京航空航天大学, 指導教員: A.P. Guanglei Zhang
- 医用コンピュータビジョンに関する研究に従事しました。
💻 Internshipsインターンシップ
- 2025.03 - 2025.07, AIGC Research Intern, RightBrain.AI, Beijing, China
- Developed and experimented with generative models for lipsync, video generation agent.
- 2024.07 - 2024.09, Medical MLLM Research Intern, United Imaging Intelligence, Beijing, China
- Contributed to the development of a Multimodal Large Language Model for Medical MLLM.
- 2025.03 - 2025.07, AIGC リサーチインターン, RightBrain.AI, 北京, 中国
- リップシンクおよび動画生成エージェント向けの生成モデルの開発と実験に従事しました。
- 2024.07 - 2024.09, 医療 MLLM リサーチインターン, United Imaging Intelligence, 北京, 中国
- 医療 MLLM のためのマルチモーダル大規模言語モデルの開発に貢献しました。
💪 Skillsスキル
- Programming: Python (PyTorch, Hugging Face Transformers, timm), C++
- Languages:
- Mandarin Chinese (Native)
- English (IELTS: 7.0)
- Japanese (JLPT N2)
- プログラミング: Python (PyTorch, Hugging Face Transformers, timm), C++
- 言語:
- 中国語(母語)
- 英語(IELTS: 7.0)
- 日本語(JLPT N2)
📧 Contact連絡先
- Email: shihr1025@gmail.com (Primary), shihr@keio.jp
- GitHub: https://github.com/nanase1025
- メール: shihr1025@gmail.com(Primary), shihr@keio.jp
- GitHub: https://github.com/nanase1025